
 企业资料通过认证

在运行了35000次测试后,它给出了非常全面的优化器算法分析介绍,并告诉你如何用这些基准测试,为自己的深度学习模型选择最好的优化方案。温州市开发票-Home。
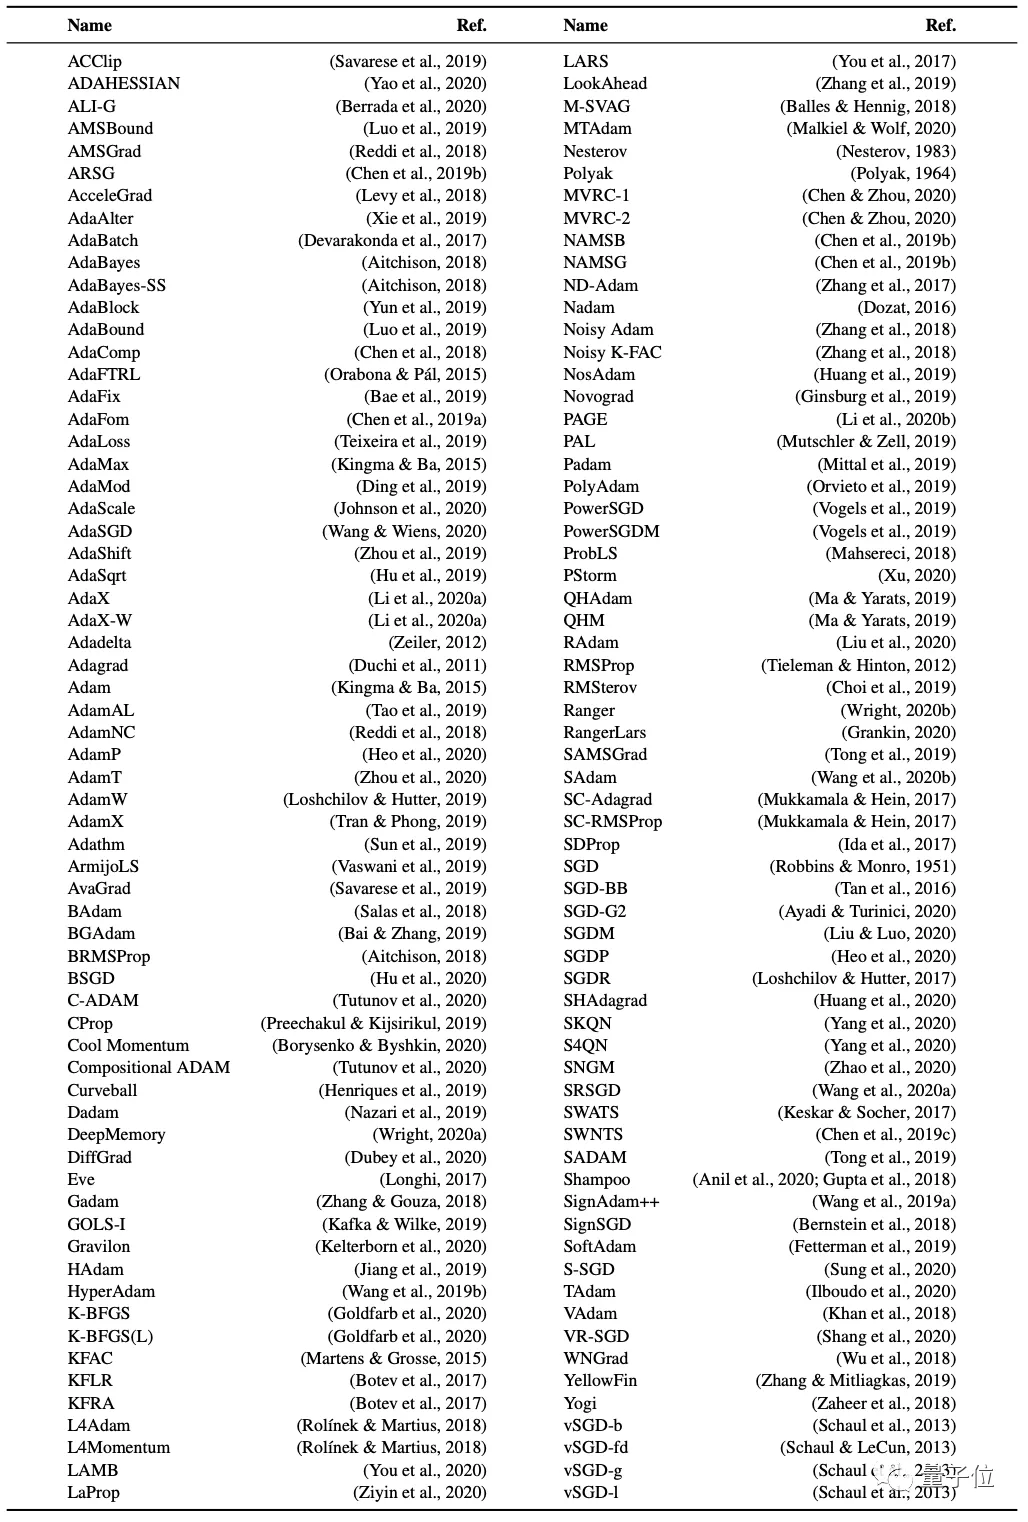
目前他们还看不出来区别,但在测试结果中可以发现,这些优化器明显能被分成两类,一种适用于VAE(变分自编码器),另一种则不适用于VAE。
而从这些优化器中的常用参数来看,α0表示初始学习率,αlo和αup代表上下界,∆t表示切换衰减样式的周期,k表示衰减因子。
可以看出,这些学习率的参数主要可以被分为常数、梯度下降、平滑下降、周期性、预热、超收敛等几种。

那么,130多种优化器,哪种才是最适用的?而对这些参数进行调整,到底能对优化器起到多大的作用?

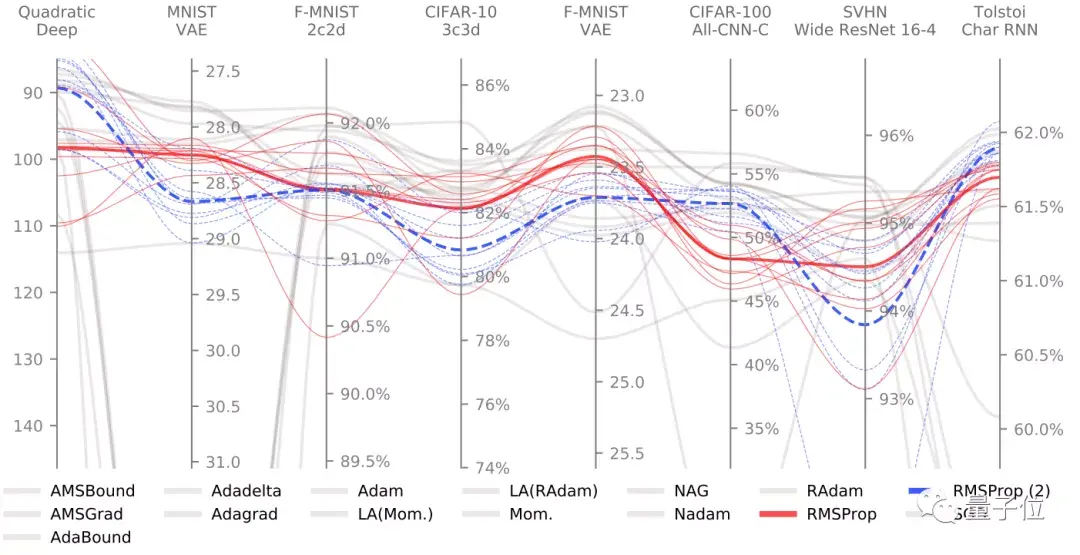
从图中看来,无论是数据集(MNIST、CIFAR-10等)、模型(VAE、CNN、RNN等),还是任务(分类、NLP等)和标准(损失率、精度)都不一样。
此外,batchsize也考虑在内(看来实验机器性能不错)。制作这些测试的目的在于,多角度考量出这些优化方法的合理性。
其中,红色的I表示误差范围。可以看出,在一定误差范围内,某一类优化方法的性能几乎非常相似:它们在各种基准测试上的表现都不错。
为了验证这些测试方法的稳定性,作者特意对其中一些算法进行了参数调整,下图是经典算法RMSProp和RMSProp(2)的调优结果。
更直接地,如果增加(性能)预算,从下图可以看出,性能的改进也会有所增加。(图中橙色为所有灰线的中值)
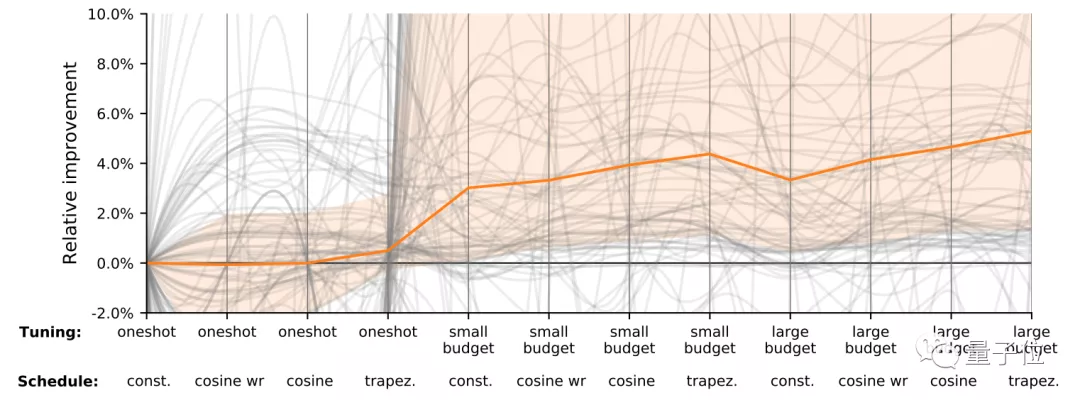

换而言之,只要某种优化算法的结果是一片绿,那么它原来的默认参数就真的很糟糕……
例如,AMSGrad、Mom、NAG的默认参数都存在很大的改进空间。相比而言,AMSBound由于自适应,默认参数都还非常不错,不需要再有大改进。
不过,虽然这份表格已经非常详细,还是有细心的网友发现了盲点:像SWA这样非常简单高效的方法,还是在分析时被遗漏了。
目前,作者已经在ArXiv论文页面,开源了基准测试方法的Code,感兴趣的小伙伴可戳论文地址查看~
Robin M. Schmidt,计算机专业研究生,主要研究方向是人工智能,感兴趣的方向在深度学习、强化学习及优化上。
Philipp Hennig,机器学习教授,兼任马普所科学家,曾于海德堡大学和帝国理工学院修读物理,并在剑桥大学获得机器学习博士学位。
Frank Schneider,机器学习博士生,研究领域是机器学习的优化方法。目前在钻研深度学习的超参数,使深度神经网络的训练自动化。