


通过服务器端和客户端的联合设计GFS对应用支持达到性能与可用性最优GFS是为Google应用程序本身而设计的,在内部部署了许多 GFS 集群有的集群拥有超过 1 000 个存储节点超过 300T 的硬盘空间被不同机器上的数百个客户端连续不断地频繁访问
读操作客户端不通过Master读取数据避免了大量读操作使Master成为系统瓶颈。
应用程序编写人员只需将精力放在应用程序本身而关于集群的处理问题包括可靠性和可扩展性则交由平台来处理
MapReduce 通过“Map(映射)”和 “Reduce(化简)”这两个简单概念来构成运算基本单元用户只需提供自己的 Map 函数以及 Reduce 函数即可并行处理海量数据
如一个基于 MapReduce 编程的用来统计文本中所有单词出现的次数的程序伪代码
此map函数中用户的程序将文本中所有出现的单词都按照出现计数1(以Key-Value对的形式) 发射到 MapReduce 给出的一个中间临时空间中通过 MapReduce 中间处理过程将所有相同的单词产生的中间结果分配到同样一个 Reduce 函数中而每一个 Reduce 函数则只需把计数累加在一起即可获得最后结果
在两个阶段之间还有一个中间的分类阶段即将中间结果中包含相同key的结果交给同一个 Reduce 函数去执行
数据库的数据项按行关键字的字典序来排列将多个行组成一个记录板每个服务器节点大约管理100个记录板
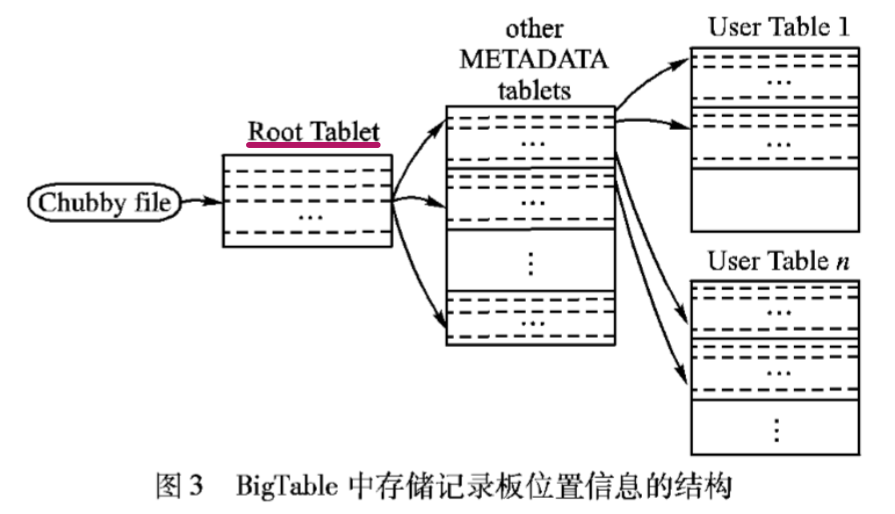
BigTable 使用 Chubby 来保存根数据表格的指针即用户可以首先从Chubby锁服务器中获得根表的位置,进而对数据进行访问
这是梁顺林的定量遥感的中文版,由范闻捷等翻译的,是电子版PDF,解决了大家看英文费时费事的问题,希望大家下载看看,一定会有帮助的
的特点 1、超大规模 2、虚拟化 3、高可靠性 4、通用性 5、高可伸缩性 6、按需服务 7、极其廉价
的分类 lIaaS:Infras tructure as a Service 将基础设施作为服务 lPaaS:Platform as a Service 将
一、分布式锁服务 今天,要接触有些难理解的知识点了,这也许就是涉及到当时赵致琢老师强调的在中国没人能有资格讲和讲得清的一块分布式算法。说实话,这块看了两遍了,到现在还不敢说自己人懂了一半啊!
设计的提供粗粒度锁服务(???)的一个文件系统,它基于松耦合分布式系统,解决了分布的一致性问题 一种建议性的锁(相信看过《UNIX环境下高级编程》的人对建议性的
到底是什么?发展现状如何?它的实现机制是什么?它与网格计算是什么关系?。本章将分析这些问题,目的是帮助读者对
》配套PPT而来的,个人觉得上面已经很经典、精简了,其道理既讲清了,也直接有现实例子,个人再去自己在上面发挥,目前既无那个才实,又无那个实验。那么,算作翻译,也谈不上,个人观念里认为翻译是针对英文原版文献的,一般英文文献读来更有质量,目前接触也只是有限,想来想去,还是算作转载吧,其实,个人更愿意将其定位为自
的搜索引擎是针对搜索引擎所面临的日益膨胀的海量数据存储问题,以及在此之上的海量数据处理问题而设计的。 众所周知,
并未拥有任何超级计算机来处理各种数据和搜索,也未使用 EMC 磁盘阵列等高端存储设备来...
中英文 (Word) 分享一下,关于谷歌的三篇论文,弄成了 中英文 word文档,便于复制粘贴。 ...
PTA练习系统显示error: redefinition of ‘main’编译错误解决方法+PTA网站验证码

