


那么在这样的背景下,如果某个服务 A 需要发布一个新版本,往往会对正在运行的其它依赖服务 A 的程序产生影响。甚至,一旦服务 A 的启动预热过程耗时过长,问题会更严重,大量请求会阻塞,产生级联影响,导致整个系统卡慢。
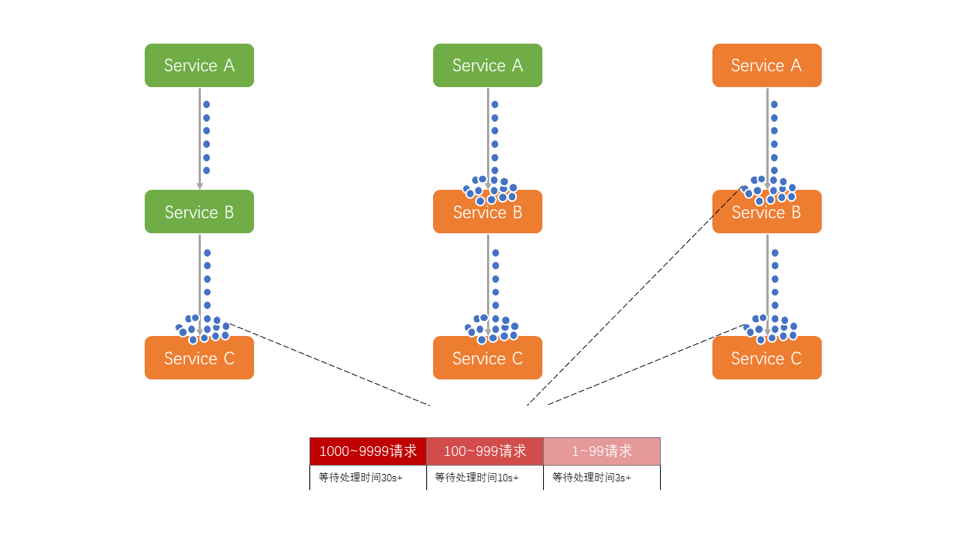
举个夸张的例子来形容:一幢楼的下水管是从最高楼直通到最低楼的,这个时候如果你家楼下的管道口堵住了,那么所有楼上的污水就会倒灌到你家。如果这导致你家的管道口也堵住了,之后又会倒灌到楼上一层,以此类推。
然而实际生活中一旦你发现了这个问题,必然会想办法先避免影响到自己家,然后跑到楼下让他们赶紧疏通管道。此时,避免影响自己家的办法就可被称之为「熔断」。
熔断本质上是一个过载保护机制。在互联网系统中的熔断机制是指:当下游服务因访问压力过大而响应变慢或失败,上游服务为了保护自己以及系统整体的可用性,可以暂时切断对下游服务的调用。
首先,需秉持的一个中心思想是:量力而行。因为软件和人不同,没有奇迹会发生,什么样的性能撑多少流量是固定的。这是根本。
但是,由于分布式系统被建立在一个并不是 100% 可靠的网络上,所以上述的情况总有发生,因此我们不能将偶发的瞬时异常等同于系统“不可用”(避免以偏概全)。由此我们需要引入一个「时间窗口」的概念,这个时间窗口用来“放宽”判定“不可用”的区间,也意味着多给了系统几次证明自己“可用”机会。但是,如果系统还是在这个时间窗口内达到了你定义“不可用”标准,那么我们就要“断臂求生”了。
• 阈值。比如,在 10 秒内出现 100 次“无法连接”或者出现 100 次大于 5 秒的请求。
• 百分比。比如,在 10 秒内有 30% 请求“无法连接”或者 30% 的请求大于 5 秒。
切断联系要尽可能的“果断”,既然已经认定了对方“不可用”,那么索性就默认“失败”,避免做无用功,也顺带能缓解对方的压力。
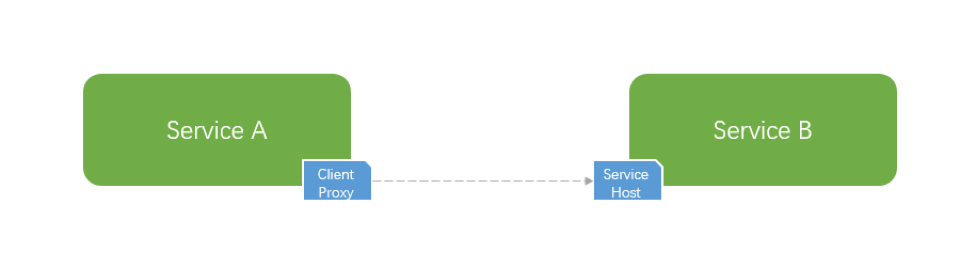
那么,这个时候作为客户端一方,在自己进程内通过代理发起调用之前就可以直接返回失败,不走网络。
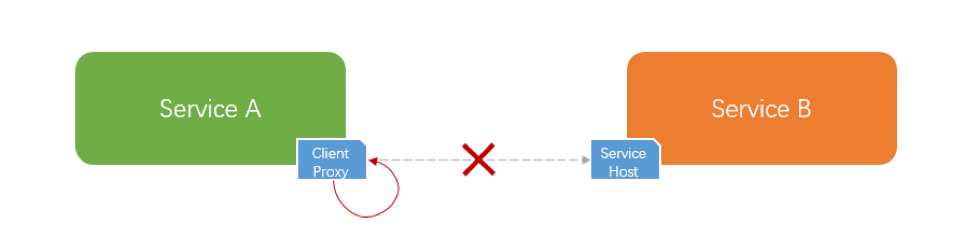
切断联系后,功能的完整性必然会受影响,所以还是需要尽快恢复回来,以提供完整的服务能力。这事肯定不能人为去干预,及时性必然会受到影响。那么如何能够自动的识别依赖系统是否“可用”呢?这也需要你来定义一个策略。
• 百分比。比如,在 10 秒内有 95% 请求“调用成功”并且 98% 的请求小于 1 秒。
稍微不同的地方在于,大多数情况下,一个系统“不可用”的状态往往会持续一段时间,不会那么快就恢复过来。所以我们不需要像第一步中识别“不可用”那样,无时无刻的记录请求状况,而只需要在每隔一段时间之后去进行探测即可。所以,这里多了一个「间隔时间」的概念。这个间隔幅度可以是固定的,比如 30 秒。也可以是动态增加的,通过线性增长或者指数增长等方式。
一旦通过了衡量是否“可用”的验证,整个系统就恢复到了“正常”状态,此时需要重新开启识别“不可用”的策略。就这样,系统会形成一个循环。
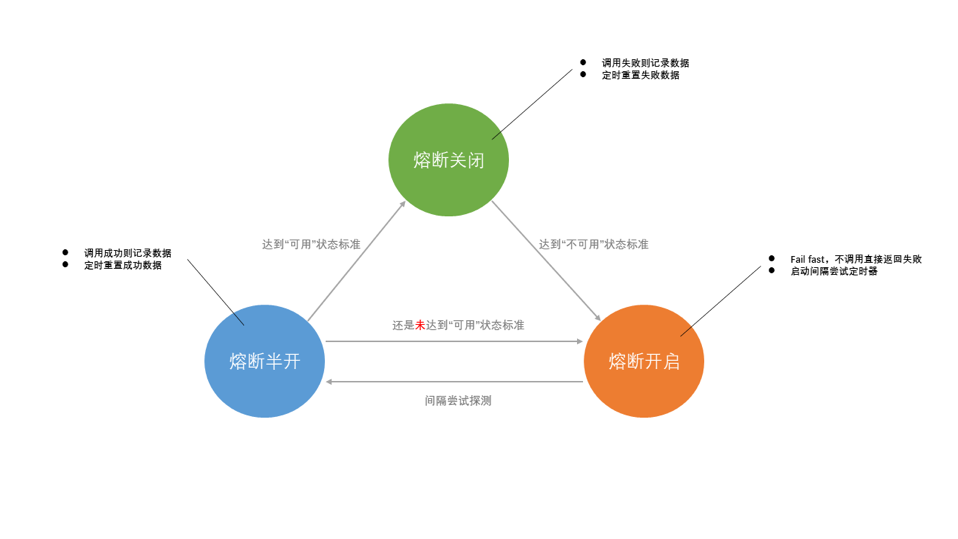
这就是一个完整的熔断机制的面貌。了解了这些核心思想,用什么框架去实施就变得不是那么重要了,因为大部分都是换汤不换药。
• 所以依赖的系统被部署在一个共享环境中(资源未做隔离),并不独占使用。比如,和某个高负荷的数据库在同一台服务器上。
• 当前所在的系统流量大小是不确定的。比如,一个电商网站的流量波动会很大,你能抗住突增的流量不代表所依赖的后端系统也能抗住。这点也反映出了我们在软件设计中带着“面向怀疑”的心态的重要性。
首先,如果所依赖的系统是多副本或者做了分区的,那么要注意其中个别节点的异常并不等于所有节点都存在异常,所以需要区别对待。
其次,熔断往往应作为最后的选择,我们应优先使用一些「降级」或者「限流」方案。因为“部分胜于无”,虽然无法提供完整的服务,但尽可能的降低影响是要持续去努力的。比如,抛弃非核心业务、给出友好提示等等,这部分内容我们会在后续的文章中展开。
上面的这些代码示例中也可以看到,熔断代码所在的位置要么在实际方法之前,要么在实际方法之后。它非常适合 AOP 编程思想的发挥,所以我们平常用到的熔断框架都会基于 AOP 去做。
熔断只是一个保护壳,在周围出现异常的时候保全自身。但是从长远来看平时定期做好压力测试才能更好的防范于未然,降低触发熔断的次数。如果清楚的知道每个系统有几斤几两,在这个基础上再把「限流」和「降级」做好,这基本就将“高压”下触发熔断的概率降到最低了。

机制的系统,它对可用性的作用至少保证了不会全盘崩溃。但是你可以想象一个稍微极端一点的场景,如果系统流量不是很稳定,导致频繁触发
这是梁顺林的定量遥感的中文版,由范闻捷等翻译的,是电子版PDF,解决了大家看英文费时费事的问题,希望大家下载看看,一定会有帮助的
可用于模拟正余弦信号的,使用运放对信号进行高倍细,已经搭建好仿真电路,可以直接运行仿真测试。
如果这是第二次看到我的文章,欢迎右侧扫码订阅我哟~ 本文长度为3319字,建议阅读9分钟。 阅读目录
总结 当我们工作所在的系统处于分布式系统初期的时候,往往这时候每个服务都只部署了一个节点。 那么在这样的背景下,如果某个服务A需要发布一个新版本,往往会对正在运行......
系统在设计之初就会有一个预估容量,长时间超过系统能承受的TPS/QPS阈值,系统可能会被压垮,最终导致整个服务不够用。为了避免这种情况,我们就需要对接口请求进行限流。限流的目的是通过对并发访问请求进行限速或者一个时间窗口内的的请求数量进行限速来保护系统,一旦达到限制速率则可以拒绝服务、排队或等待。常见的限流模式有控制并发和控制速率,一个是限制并发的数量,一个是限制并发访问的速率。控制并发数量属于一种...
线程池/信号量THREAD(线程隔离)使用该方式,HystrixCommand将会在单独的线程上执行,并发请求受线程池中线程数量的限制。不同服务通过使用不同线程池,彼此间将不受影响,达到隔离效果。hystrix将使用独立的线程池对应每一个服务提供者,用于隔离和限制这些服务。于是某个服务提供者的高延迟或者资源受限只会发生在该服务提供者对应的线程池中。SEMAPHORE(信号量隔离)其实就是......
